Chapitre 2 : Comment l’IA apprend et prend des décisions
Les données façonnent ce que l’IA apprend
Les données façonnent ce que l’IA apprend
Les modèles d’IA apprennent à partir de données, mais ces données ne sont pas une représentation neutre ou complète du monde. Elles reflètent l’information qu’il était possible de recueillir, les choix que des personnes ont faits quant à ce qu’il fallait inclure et, parfois, ce qui a été laissé de côté. Ces choix peuvent façonner ce qu’un système d’IA apprend, ce qu’il reconnaît et la façon dont il réagit.
Tous les systèmes d’IA n’apprennent pas à partir du même type ou de la même quantité de données. Les données nécessaires dépendent de la fonction pour laquelle le système a été conçu. Un modèle peut apprendre à partir d’images, un autre à partir de texte et un autre à partir de mesures ou d’observations. Certains systèmes exigent aussi beaucoup plus de données d’entraînement que d’autres. Ce qui importe, ce n’est pas simplement la quantité de données dont dispose un système, mais le fait que ces données conviennent à ce qu’on lui demande de faire.
Imaginez un modèle d’apprentissage automatique comme un élève à qui l’on n’a donné que des livres d’histoire écrits d’un seul point de vue. Au moment de rédiger un rapport, cet élève ne peut s’appuyer que sur l’information qu’il a rencontrée. Sa compréhension peut être approfondie dans certains domaines tout en omettant d’importantes voix, expériences ou perspectives.
Quelque chose de semblable peut se produire avec l’IA. Si certains groupes, expériences ou points de vue sont absents ou sous-représentés dans les données utilisées pour entraîner un modèle, le système pourrait avoir du mal à en tenir compte. Si les données contiennent des erreurs ou reflètent des biais existants, ces schémas peuvent aussi se retrouver dans les résultats du modèle. Un résultat est ce que produit un système d’IA après avoir reçu une entrée. Il peut s’agir d’une prédiction, d’une classification, d’une recommandation, d’une réponse générée, d’une image ou d’un autre type de résultat.
L’exemple ci-dessus montre pourquoi les données qui sous-tendent un système d’IA peuvent avoir de l’importance. Avant d’examiner de plus près d’où viennent ces données et ce qu’elles peuvent laisser de côté, il est utile de comprendre quelques termes qui reviendront tout au long de ce sujet.
C’est pourquoi les données qui sous-tendent un système d’IA sont si importantes. Elles ne se contentent pas de fournir de l’information au modèle pour qu’il apprenne. Elles contribuent à déterminer ce que le système peut reconnaître, ce qui peut lui échapper et la façon dont il réagit au monde.
D’où viennent les données ?
Nous savons que les systèmes d’IA apprennent à partir de données, mais d’où viennent réellement toutes ces données ?
Il n’y a pas de réponse unique. La source dépend du type de système d’IA, de ce qu’il est conçu pour faire et de la façon dont il a été développé. Les données d’entraînement peuvent comprendre du texte, des images, du contenu audio, des vidéos, des mesures, des dossiers et de nombreuses autres formes d’information. Elles peuvent aussi provenir de nombreuses sources différentes (CloudHop, 2025; OpenAI, 2026).
Voici quelques sources courantes :
Information accessible au public
Certains modèles d’IA apprennent à partir d’information accessible publiquement en ligne. Il peut s’agir de pages Web, de blogues, de forums publics, de publications publiques, d’images ou d’autres contenus librement accessibles. Les modèles d’IA utilisés dans les outils de clavardage populaires peuvent apprendre à partir d’énormes collections de ce type d’information.
Ensembles de données organisés ou conçus à dessein
Parfois, des données sont délibérément recueillies et organisées pour une fin particulière. Par exemple, un ensemble de données conçu pour aider un système d’IA à reconnaître des objets peut contenir des milliers d’images étiquetées selon ce qu’elles montrent.
Données organisationnelles ou spécialisées
Les organisations peuvent aussi utiliser leurs propres données pour développer des systèmes d’IA à des fins précises. Selon le contexte, il peut s’agir de dossiers historiques, d’interactions avec la clientèle, d’images de produits, de relevés de capteurs, d’images médicales ou d’autres renseignements spécialisés.
Données créées ou étiquetées par des humains
Les personnes jouent un rôle important dans la préparation des données pour l’IA. Des contributeurs humains peuvent étiqueter des images, classer de l’information, rédiger des exemples ou évaluer et corriger des réponses. Cela fournit au système de l’information à partir de laquelle apprendre ou qu’il peut utiliser à différentes étapes de son développement.
Dans l’apprentissage supervisé, des personnes peuvent étiqueter des exemples pour que le modèle dispose de bonnes réponses à partir desquelles apprendre. Dans l’apprentissage non supervisé, les données ne sont pas accompagnées de ces étiquettes prédéfinies. Dans les deux cas, les données auxquelles le modèle a accès façonnent les schémas qu’il est en mesure d’apprendre.
Données synthétiques
Tous les exemples d’entraînement ne proviennent pas directement du monde réel. Les données synthétiques sont de l’information générée artificiellement pour compléter d’autres données. Elles peuvent être utiles lorsque les exemples du monde réel sont limités ou lorsque les développeurs veulent obtenir des exemples supplémentaires de situations particulières.
Associez les données à leur source
Les choix qui se cachent derrière les données
Chaque ensemble de données a une histoire. Des personnes font des choix quant à l’information qui est recueillie, sélectionnée, organisée, étiquetée et utilisée pour développer un système d’IA. Cela nous amène à nous poser certaines questions importantes : Qui a créé les données ? Qui a choisi ce qui y a été inclus ? À qui appartiennent-elles ou qui a la permission de les utiliser ? Qui y est représenté ? Et les expériences ou les perspectives de quelles personnes pourraient manquer ?
Ce qui est représenté (et ce qui ne l’est pas ?)
Disposer de beaucoup de données d’entraînement ne signifie pas nécessairement que tout le monde et toutes les réalités y sont représentés également. Certaines langues, régions, communautés, perspectives et expériences peuvent apparaître fréquemment dans un ensemble de données, alors que d’autres peuvent être moins courantes, voire absentes.
Cela est important parce que les systèmes d’IA apprennent des schémas à partir des exemples dont ils disposent. Si certaines personnes, certains lieux ou certaines situations sont sous-représentés, le système dispose de moins d’exemples à partir desquels apprendre à leur sujet. C’est pourquoi il est important de tenir compte non seulement de la quantité de données avec lesquelles un système d’IA a été entraîné, mais aussi de ce que ces données représentent.
Un ensemble de données peut être très volumineux tout en comportant d’importantes lacunes. Davantage de données ne signifie pas automatiquement des données plus représentatives.
Qu’est-ce que cela pourrait signifier en éducation ?
Des questions semblables se posent lorsque l’IA est utilisée pour traiter la langue, l’histoire, la culture et d’autres formes de savoir. L’UNESCO met en garde contre le fait que l’IA générative a tendance à reproduire les points de vue courants ou dominants qui apparaissent fréquemment dans ses données d’entraînement. Les communautés dont la présence numérique est plus limitée peuvent donc être moins représentées, tant dans les données que dans les résultats qui en découlent (Miao & Holmes, 2023).
« Leurs voix ne sont par conséquent pas entendues et leurs préoccupations ne sont pas représentées dans les données utilisées pour entraîner les GPT, et elles apparaissent donc rarement dans les résultats. »
Pour le personnel éducatif et les élèves, cela signifie qu’il vaut la peine de se demander non seulement « Que sait le système ? », mais aussi « Quelles connaissances et quelles expériences pourraient manquer, et à qui appartiennent-elles ? »
Quand les données comportent des biais
Dans la section précédente, nous avons exploré ce qui peut se produire lorsque certaines personnes, communautés ou perspectives sont sous-représentées dans les données d’entraînement. Il s’agit d’un exemple de biais de représentation. Mais la représentation n’est qu’un des endroits où un biais peut apparaître. Un biais peut aussi refléter des schémas historiques déjà présents dans les données, des choix faits pendant le développement d’un modèle et le contexte dans lequel un système d’IA est utilisé.
Cela ne signifie pas nécessairement que quelqu’un a conçu intentionnellement un système injuste. Les systèmes d’IA apprennent à partir d’information sur notre monde et sont façonnés par des décisions humaines tout au long du processus. Les inégalités, les lacunes, les hypothèses ou les choix de conception existants peuvent donc influencer ce qu’un système apprend et son efficacité pour différentes personnes.
D’où vient le biais ?
Le biais ne s’introduit pas dans un système d’IA à un seul endroit. Il peut commencer par des schémas déjà présents dans les données, apparaître dans le choix des exemples retenus pour un ensemble de données, être introduit ou renforcé pendant l’entraînement du modèle, ou résulter de la façon dont le système final est utilisé. Le diagramme ci-dessous suit ce parcours simplifié à travers un système d’IA. Explorez chaque point pour voir où différentes formes de biais peuvent entrer en jeu.
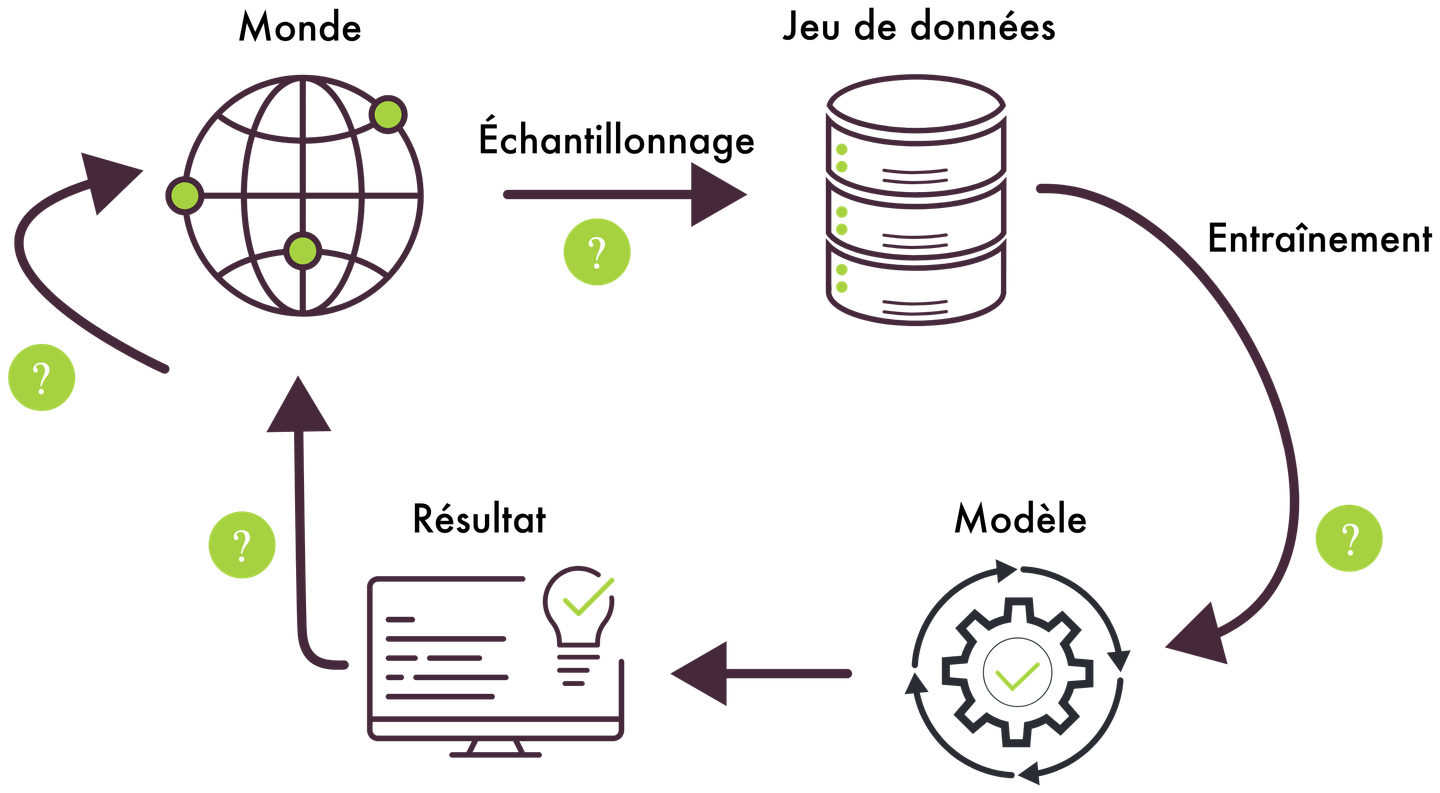
Biais historique (le passé)
Quels schémas du passé se reflètent dans les données ?
Les données historiques peuvent refléter des inégalités, des stéréotypes ou des schémas sociaux existants. Un système d’IA qui apprend à partir de ces renseignements peut aussi apprendre ces schémas. Un exemple serait un système linguistique d’IA qui apprend à associer certaines professions à certains genres à partir de schémas qui reviennent régulièrement dans des textes historiques.
Biais de représentation (l’entrée)
Qui ou quoi est bien représenté, et qui pourrait manquer ?
L’échantillonnage est le processus qui consiste à choisir les exemples qui sont inclus dans un ensemble de données. Si certains groupes, communautés, expériences ou perspectives apparaissent moins souvent dans les données d’entraînement, le système dispose de moins d’exemples à partir desquels apprendre à leur sujet. Un exemple serait un système de reconnaissance d’images entraîné avec de nombreux exemples provenant de certaines régions du monde, mais beaucoup moins d’exemples provenant d’autres régions.
Biais d’apprentissage (le processus)
Qu’est-ce que le modèle est entraîné à privilégier ?
La façon dont un modèle est entraîné compte aussi. Optimiser un objectif, comme l’exactitude globale, peut parfois se faire au détriment d’autres considérations, notamment le rendement du modèle auprès de groupes plus petits ou sous-représentés. Un exemple serait un modèle optimisé principalement pour l’exactitude globale, même si cela se traduit par un rendement moindre pour un groupe plus restreint représenté dans les données.
Biais de déploiement (le résultat et l’avenir)
Le système est-il utilisé dans un contexte approprié ?
Même un système bien conçu peut causer des problèmes s’il est utilisé à une fin, auprès d’une population ou dans une situation différents de ceux pour lesquels il a été conçu et évalué. Un exemple serait un système d’IA conçu et mis à l’essai à une fin précise, puis utilisé plus tard pour éclairer une décision à plus fort enjeu qu’il n’a pas été conçu pour prendre.
Données erronées en entrée, résultats erronés en sortie
Vous avez peut-être déjà entendu l’expression « garbage in, garbage out », qui signifie « données erronées en entrée, résultats erronés en sortie ». Cette expression courante exprime l’idée que la qualité de ce qui entre dans un système peut influer sur la qualité de ce qui en sort.
La même idée s’applique à l’IA. Un modèle apprend des schémas à partir des données dont il dispose ; les erreurs, les informations manquantes ou les données mal adaptées à la tâche peuvent donc influer sur ce que le modèle apprend. Et, comme nous l’avons déjà vu, avoir beaucoup de données ne signifie pas nécessairement avoir de bonnes données.
Alors, qu’est-ce qui rend les données utiles pour l’IA ?
Quand les données sont inexactes :
Imaginez un système de reconnaissance d’images entraîné à identifier différentes espèces d’arbres. Si bon nombre d’images sont mal étiquetées, le modèle peut apprendre de mauvaises associations et faire plus d’erreurs lorsqu’il identifie de nouveaux arbres.
Quand les données sont exactes :
Les images sont étiquetées avec exactitude et vérifiées pour déceler les erreurs, ce qui donne au modèle des exemples plus fiables à partir desquels apprendre.
Idée clé : L’IA peut assimiler les erreurs contenues dans ses données d’entraînement tout autant que l’information exacte.
Qu’en est-il de l’information périmée ?
Les données pertinentes doivent aussi convenir à la période et au contexte dans lesquels un système d’IA est utilisé. Par exemple, un modèle d’IA peut avoir été entraîné à partir d’information recueillie avant un changement de politique, une découverte scientifique ou un événement mondial récent.
Certains outils d’IA peuvent maintenant effectuer des recherches sur le Web ou se connecter à d’autres sources d’information à jour, tandis que d’autres s’appuient principalement sur l’information apprise pendant l’entraînement. Dans tous les cas, on ne devrait pas présumer automatiquement qu’une réponse de l’IA est à jour ou exacte. Lorsque l’information à jour est importante, vérifier la réponse auprès d’une source fiable fait partie d’une utilisation réfléchie de l’IA.
Les données ne racontent jamais toute l’histoire
Nous avons vu que les données jouent un rôle majeur dans ce que les systèmes d’IA apprennent. Ce qui est inclus, qui et quoi est représenté, la qualité de l’information et les choix faits en cours de route peuvent tous influencer ce qu’un système apprend et produit.
Mais les données ne racontent jamais toute l’histoire. Négliger les contextes sociaux, culturels, historiques et humains qui entourent les données peut avoir des conséquences bien réelles. Les systèmes d’IA peuvent être moins fiables pour certains groupes, omettre certaines perspectives dans leurs réponses ou produire de l’information inexacte ou mal adaptée à la situation dans laquelle elle est utilisée.
Pour le personnel éducatif, la littératie en IA signifie apporter du contexte et un jugement professionnel à ce que fournit un système d’IA. Elle signifie aussi aider les élèves à se demander ce qui pourrait manquer, quelles perspectives sont représentées et si un résultat est logique dans le contexte où il est utilisé.