Chapitre 2 : Comment l’IA apprend et prend des décisions
Des schémas aux prédictions
Des schémas aux prédictions
Jusqu’ici, nous avons exploré comment les modèles d’IA apprennent des schémas à partir de données et appliquent ces connaissances à de nouvelles informations. Nous allons maintenant examiner de plus près comment les modèles utilisent ces schémas pour produire un résultat.
Dans bon nombre de systèmes d’IA, produire un résultat consiste à faire une prédiction. En IA, une prédiction ne consiste pas toujours à prévoir ce qui se produira dans l’avenir. Selon la tâche, une prédiction peut prendre différentes formes.
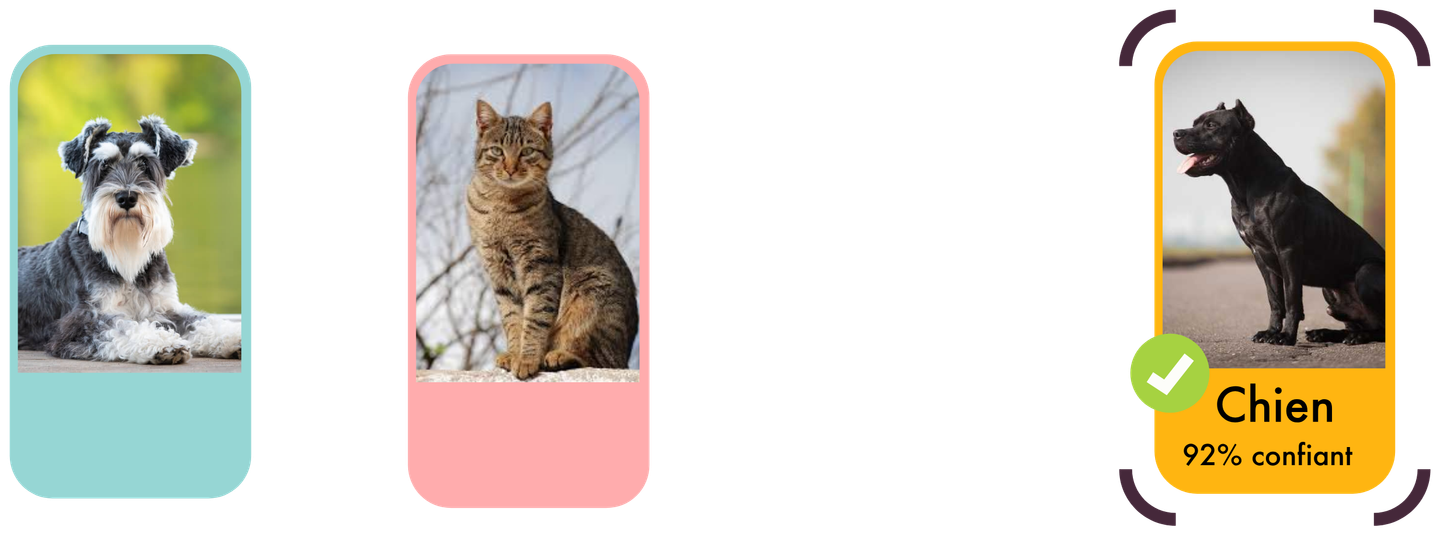
Une prédiction peut consister à reconnaître ce qu’est quelque chose. La classification d’images est le cas où le modèle utilise des schémas appris pour prédire à quelle catégorie une image appartient le plus probablement.
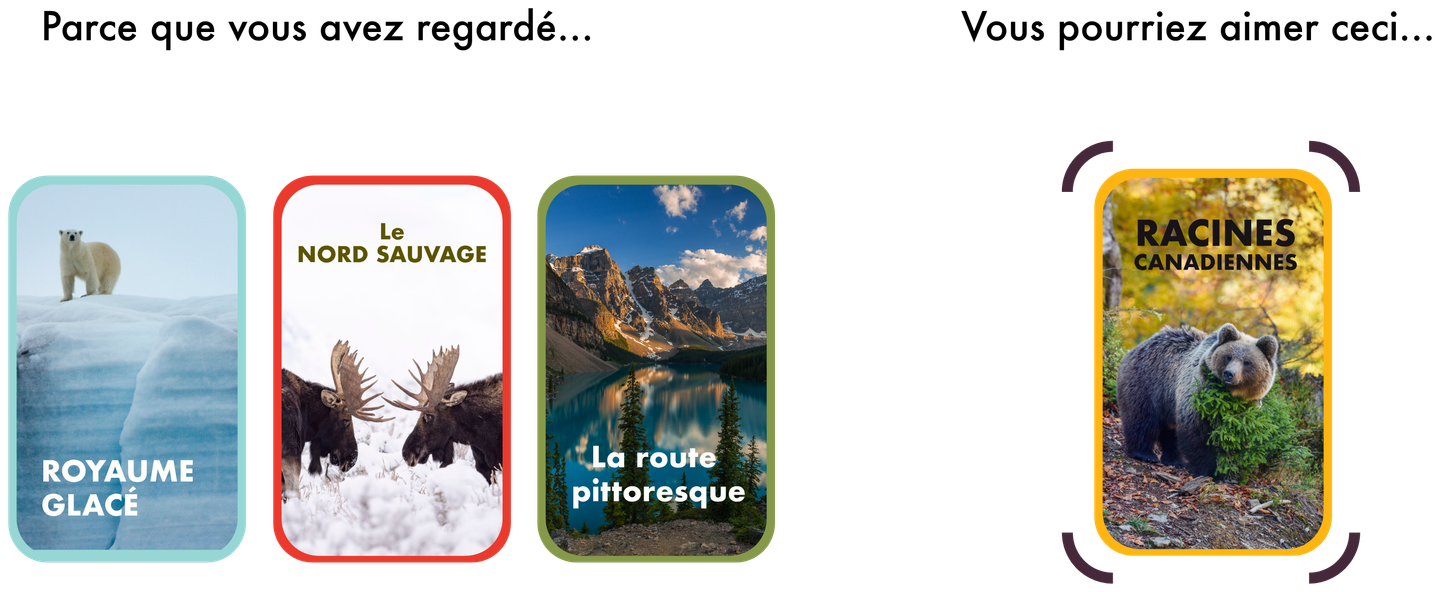
Une prédiction peut consister à recommander ce qui pourrait vous plaire. Les systèmes de recommandation utilisent des schémas dans l’activité antérieure pour prédire ce qui pourrait intéresser une personne ensuite.
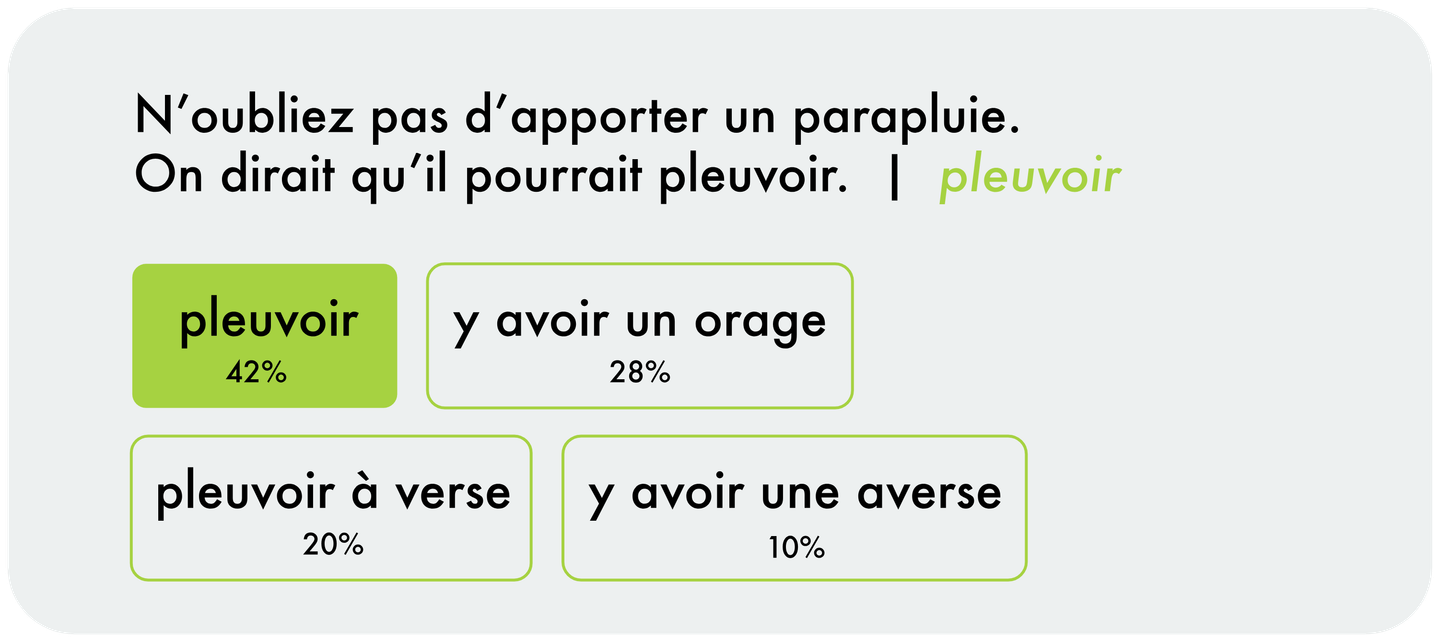
Une prédiction peut consister à prédire ce qui vient ensuite. La modélisation du langage utilise des schémas linguistiques et le contexte établi jusqu’à présent pour prédire ce qui est le plus susceptible de suivre.
Qu’un modèle reconnaisse une image, recommande du contenu ou prédise la suite d’une phrase, sa prédiction repose sur des schémas appris pendant l’entraînement. Nous examinerons maintenant de plus près comment les modèles repèrent ces schémas et ces relations à partir de nombreux exemples.
Repérer des schémas
Pendant l’entraînement, un modèle traite de nombreux exemples et repère des schémas et des relations statistiques dans les données. Ces schémas aident le modèle à distinguer différents types d’information.
Par exemple, imaginez un modèle entraîné à reconnaître des nombres écrits à la main. On pourrait lui montrer de nombreux exemples de chaque nombre, écrits de différentes façons.
Exemples tirés des données d’entraînement
Deux 7 écrits à la main ne sont jamais tout à fait identiques. Mais à partir de nombreux exemples, le modèle peut repérer dans l’information visuelle des schémas qui l’aident à distinguer un 7 d’un 3, d’un 1 ou d’un autre nombre.
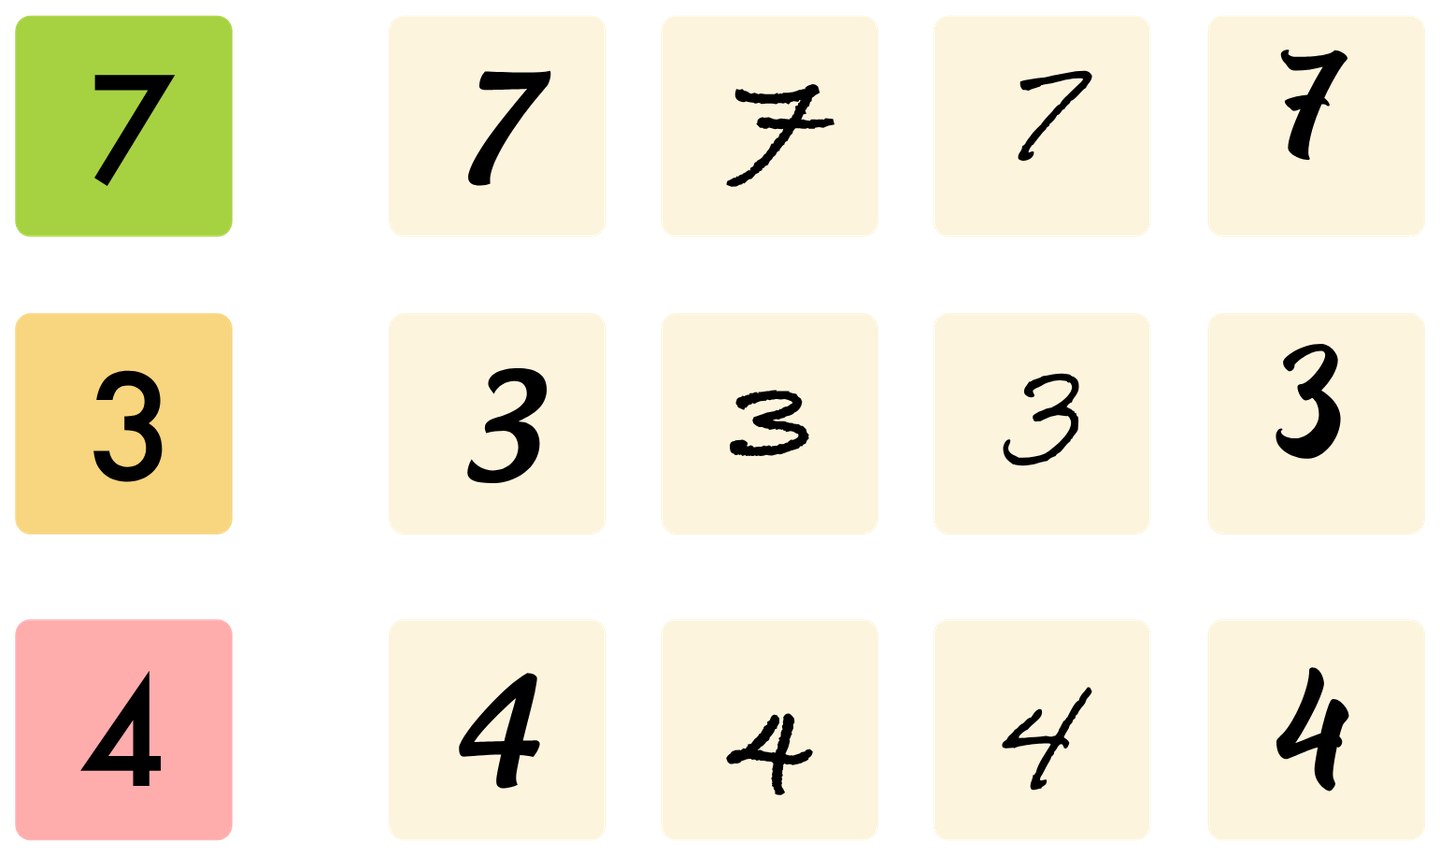
Le modèle ne mémorise pas une version parfaite de chaque nombre. Il apprend quels schémas et quelles relations statistiques apparaissent dans l’ensemble des données d’entraînement. Cela lui permet d’utiliser ce qu’il a appris lorsqu’il rencontre un exemple entièrement nouveau.
Faire une prédiction
Imaginons maintenant que nous donnons à notre modèle d’écriture manuscrite une image qu’il n’a jamais vue. Plutôt que de chercher une correspondance exacte dans ses données d’entraînement, le modèle utilise les schémas appris pour estimer quel nombre la nouvelle image représente le plus probablement.
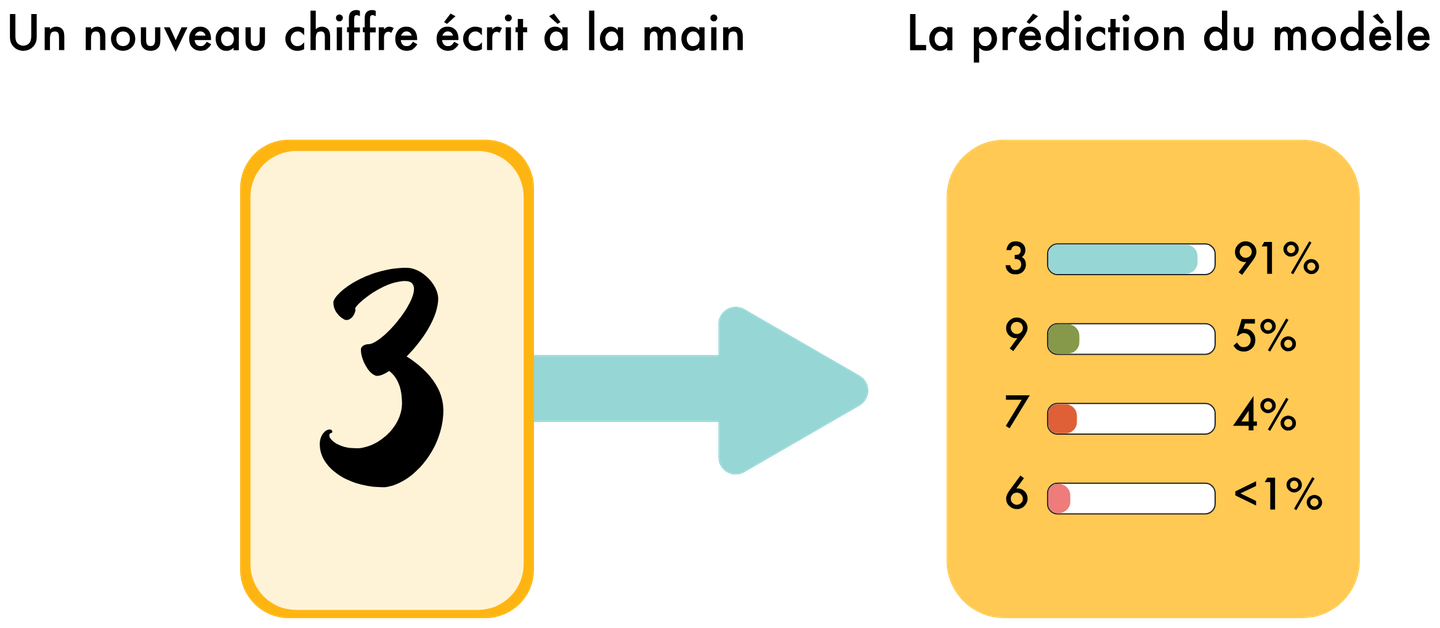
Le modèle pourrait attribuer la probabilité la plus élevée au 3, tout en attribuant des probabilités plus faibles aux autres possibilités. C’est ce que nous entendons par une prédiction : le modèle estime le résultat le plus probable à partir des schémas appris pendant l’entraînement (Zhang et al., 2023). Une prédiction représente ce que le modèle considère comme le plus probable. Cela ne signifie pas que le modèle est certain.
Comment l’IA générative prédit
Lorsque vous saisissez une requête, le modèle traite le texte sous forme de petites unités appelées jetons. Un jeton peut être un mot entier, une partie de mot, un signe de ponctuation ou un fragment de texte.
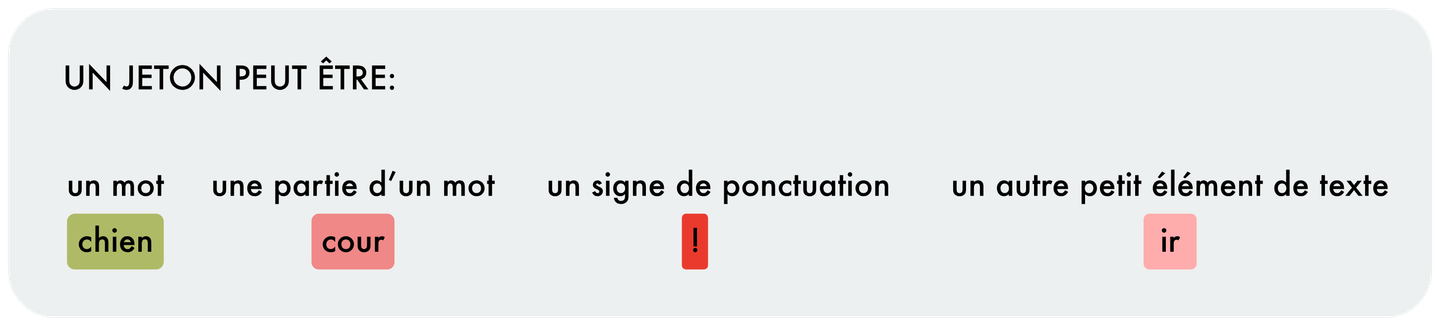
Par exemple, une courte phrase pourrait être découpée en jetons de cette façon :
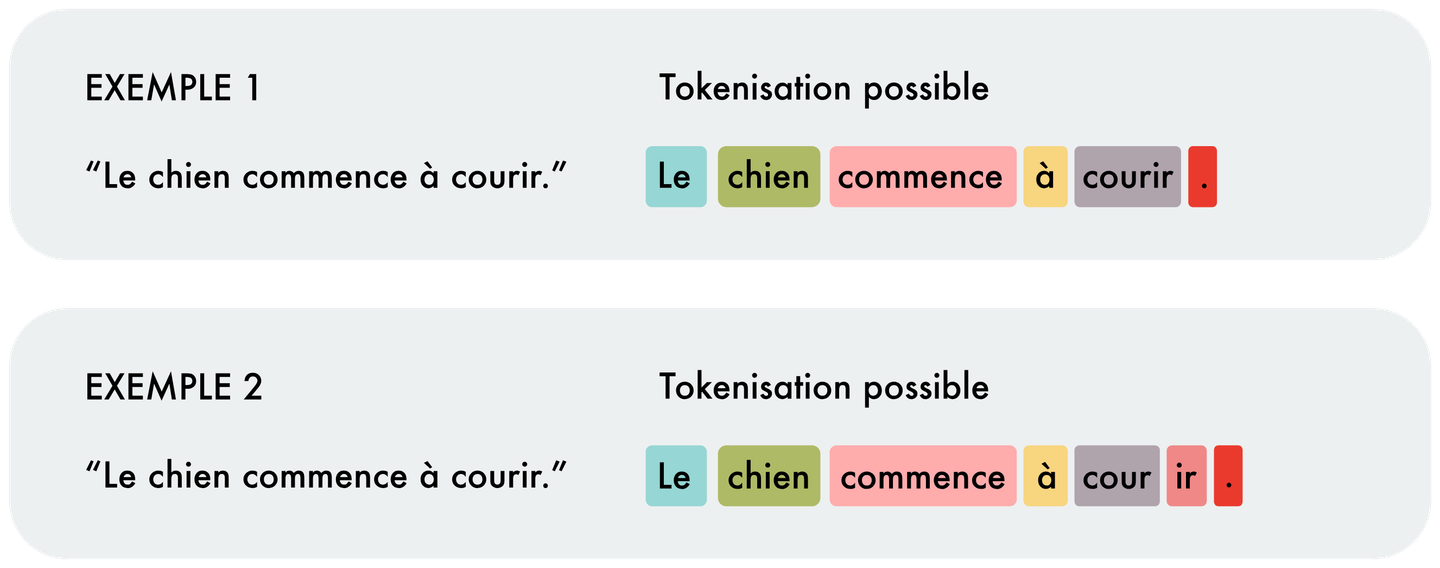
Les jetons exacts peuvent varier selon le modèle. L’idée essentielle est qu’un modèle de langage traite le texte en petites unités plutôt que de traiter simplement le langage une phrase entière à la fois. Le modèle utilise ensuite les schémas appris pendant l’entraînement pour calculer les probabilités du jeton qui pourrait venir ensuite, compte tenu du contexte jusqu’à présent (Zhang et al., 2023).
Imaginez que vous commencez une phrase par :
« Les élèves ont ouvert leurs livres à la page… »
Qu’est-ce qui pourrait plausiblement suivre ?
Plusieurs possibilités pourraient raisonnablement suivre. À partir du contexte et des schémas appris pendant l’entraînement, le modèle détermine quelles possibilités sont plus ou moins probables et génère le jeton suivant. Puis il recommence.
Chaque nouveau jeton fait partie du contexte utilisé pour prédire la suite. Comme le modèle a appris des schémas et des relations complexes dans le langage pendant l’entraînement, ces prédictions peuvent s’appuyer sur les mots et les idées qui précèdent.
Pourquoi la même requête peut produire des réponses différentes
Si vous avez utilisé l’IA générative plus d’une fois, vous avez peut-être remarqué que saisir la même requête ne produit pas toujours la même réponse. La raison tient à la prédiction et aux probabilités.
Une calculatrice offre une comparaison utile. Si vous saisissez le même calcul dans une calculatrice, vous vous attendez à obtenir la même réponse chaque fois. Un modèle de langage fonctionne différemment. Comme nous l’avons vu plus tôt avec les nombres écrits à la main, un modèle envisage plusieurs possibilités pour la suite, chacune ayant une probabilité différente.
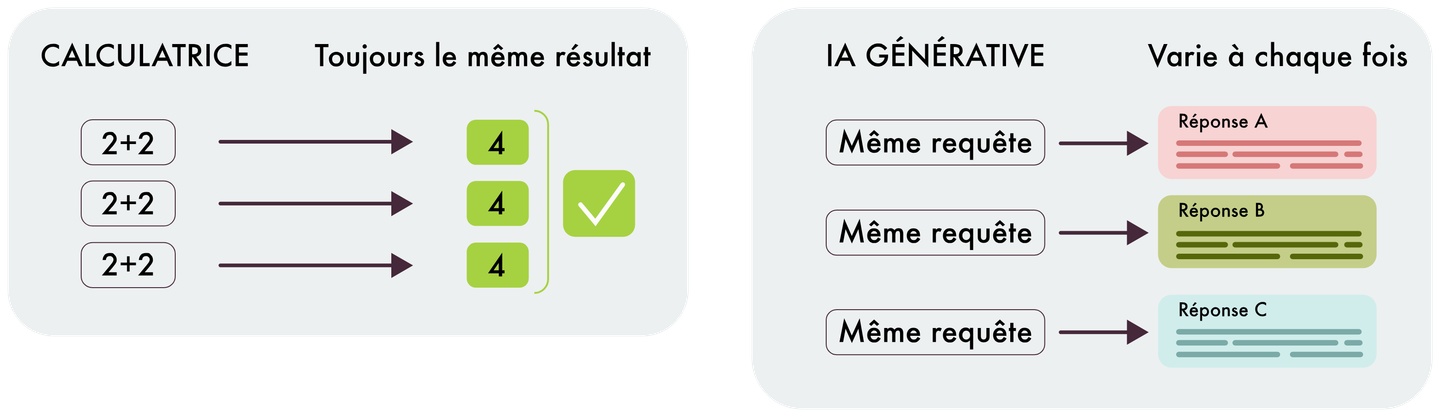
Un modèle de langage ne suit pas toujours la même séquence de prédictions. Un choix différent au début de la réponse change le contexte de ce qui vient ensuite (Zhang et al., 2023). À mesure que ce processus se poursuit, ces différences peuvent mener à des réponses dont la formulation, les exemples, les explications ou les conclusions diffèrent.
Se tromper avec assurance
Comprendre comment l’IA générative produit une réponse aide à expliquer l’une de ses limites importantes. Un modèle de langage génère du texte à partir de schémas et de probabilités, mais une réponse qui correspond à ces schémas n’est pas nécessairement exacte sur le plan factuel. L’IA peut donc produire de l’information qui semble convaincante tout en se trompant sur les faits, en combinant mal des informations ou même en inventant des détails. Ces types d’erreurs sont souvent appelés hallucinations (Huang et al., 2023).
Les modèles et les outils varient quant à leur exactitude, mais on ne devrait jamais présumer automatiquement qu’un système d’IA générative est exact. Lorsque l’exactitude est importante, il faut vérifier l’information importante auprès d’une source fiable.
Nous explorerons beaucoup plus en détail les hallucinations, les inexactitudes et les risques qu’elles peuvent créer au chapitre 3 : Risques et réalités.